

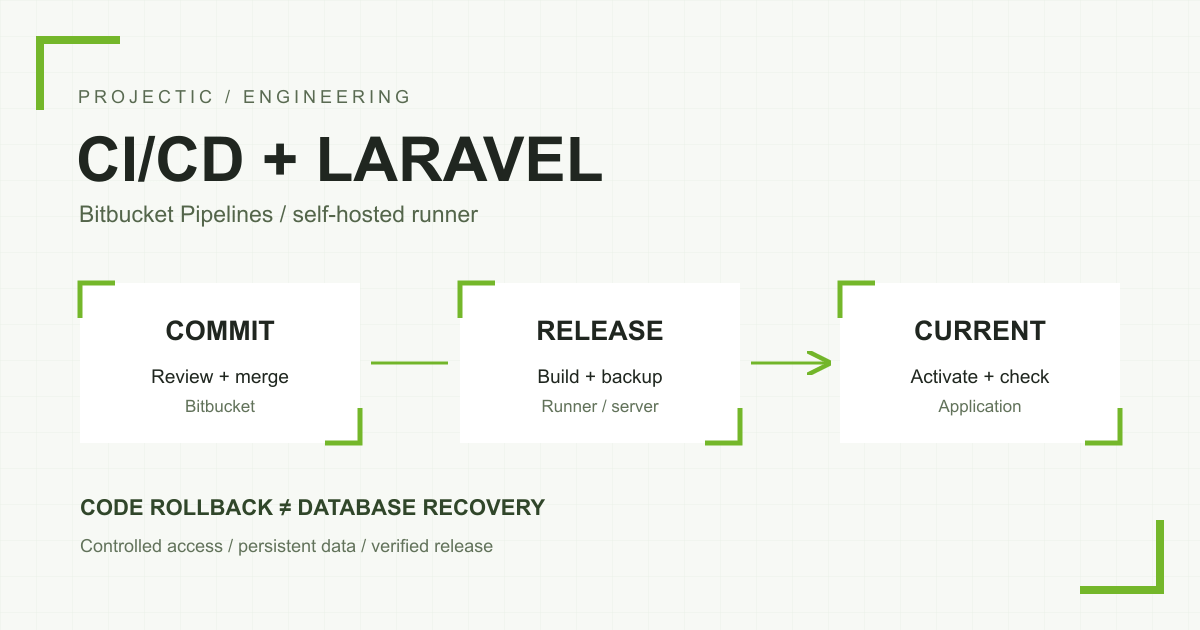
Automatyczne wdrażanie aplikacji Laravel nie wymaga udostępniania SSH wszystkim serwerom wykonującym zadania CI/CD. Jeżeli serwer przyjmuje połączenia administracyjne tylko z wybranych adresów, jedną z możliwości jest własny runner Bitbucket Pipelines. W naszym wdrożeniu runner odbiera zadania przez połączenia wychodzące, a kontrolowany skrypt publikuje wskazany commit. Reguły dostępu przychodzącego pozostają bez zmian.
Opisujemy rozwiązanie zastosowane przy przygotowaniu infrastruktury sezonowej aplikacji. Zespół potrzebował powtarzalnych wdrożeń po zatwierdzeniu zmian w repozytorium oraz możliwości powrotu do poprzedniego kodu. Standardowy scenariusz, w którym runner chmurowy łączy się z produkcją przez SSH, nie pasował do istniejącej listy dozwolonych adresów. Zamiast rozszerzać ją o kolejne źródła, zmieniliśmy miejsce wykonywania zadania.
Co daje CI/CD przy utrzymaniu aplikacji?
Ręczne wysyłanie plików pozostawia kilka pytań: czy trafił cały komplet zmian, czy zależności są aktualne i czy działający kod odpowiada wersji w repozytorium? Powtarzalny proces powinien dawać na nie konkretną odpowiedź. W opisywanym rozwiązaniu podstawą wdrożenia jest pełny identyfikator commita. Wynik zadania pozwala ustalić, które wydanie zostało uruchomione.
Automatyzacja nie zastępuje testów ani przeglądu kodu. Tutaj jest ostatnim etapem uzgodnionego procesu: praca w osobnej gałęzi, pull request, weryfikacja i scalenie do master. Dopiero aktualizacja tej gałęzi uruchamia publikację. Nazwa gałęzi jest wyborem projektu, w innym repozytorium może to być main.
Dlaczego własny runner rozwiązał problem z SSH?
Runner to proces wykonujący kroki pipeline’u. W tym przypadku uruchomiliśmy go na własnej infrastrukturze, przy konkretnym repozytorium. Po otrzymaniu zadania wywołuje lokalny punkt wejścia wdrożenia. Bitbucket nie musi rozpoczynać nowego połączenia SSH do serwera aplikacji.
Trzeba nadal zapewnić dozwolony ruch wychodzący: komunikację runnera z usługami Bitbucket oraz pobranie repozytorium i zależności. Kierunek połączenia ma znaczenie. Ograniczenie dostępu przychodzącego nie oznacza, że serwer może działać bez dostępu do usług zewnętrznych. Aktualne wymagania sieciowe należy sprawdzić w dokumentacji Atlassian dotyczącej zapór.
Przykład pipeline’u: mało logiki w YAML
Poniższy przykład pokazuje podział odpowiedzialności, nie kompletną instalację. Etykieta runnera i nazwa polecenia są przykładowe. Przed jego użyciem potrzebne są skonfigurowany runner, chroniona gałąź oraz sprawdzony skrypt z właściwymi uprawnieniami.
definitions:
  steps:
    - step: &deploy
        name: Deploy reviewed commit
        deployment: production
        runs-on:
          - self.hosted
          - linux.shell
          - app.production
        script:
          - test "$BITBUCKET_BRANCH" = master
          - sudo -n /usr/local/sbin/app-deploy "$BITBUCKET_COMMIT"

pipelines:
  branches:
    master:
      - step: *deploy
  custom:
    deploy-production:
      - step: *deploy
W naszym rozwiązaniu właściwa procedura znajduje się w kontrolowanym skrypcie na serwerze. Sprawdza argument, potwierdza obecność commita w historii dozwolonej gałęzi i blokuje jednoczesne wdrożenia. Sam warunek w YAML nie jest wystarczającą granicą bezpieczeństwa, bo osoba mogąca zmienić pipeline może także zmienić ten warunek.
Kto ma prawo wdrażać kod?
Konto runnera otrzymało dostęp do odczytu jednego repozytorium oraz możliwość wywołania konkretnego polecenia wdrożeniowego, bez ogólnego dostępu do sudo. Git, Composer, npm i kod aplikacji są wykonywane przez konta bez uprawnień roota. Uprzywilejowany punkt wejścia odpowiada za operacje systemowe i kontrolę parametrów.
To nadal istotne uprawnienie. Osoba mogąca doprowadzić własny kod do wdrażanej gałęzi uzyskuje możliwość uruchomienia kodu aplikacji. Dlatego reguły repozytorium, dostęp do pipeline’ów i uprawnienia na serwerze trzeba rozpatrywać razem. Nie uruchamiamy na takim runnerze niesprawdzonych forków ani zadań obcych projektów.
Wybrany przez nas Linux Shell wykonuje polecenia bezpośrednio na hoście. Nie zapewnia nowego, odizolowanego środowiska dla każdego kroku, co opisuje dokumentacja Linux Shell Runner. Przy innym poziomie ryzyka warto oddzielić budowanie od produkcji i dostarczać zweryfikowany artefakt. Wspólny serwer jest decyzją projektową, nie uniwersalnym zaleceniem.
Nowe wydanie powstaje obok działającego
Nie nadpisujemy plik po pliku katalogu obsługującego użytkowników. Każde wdrożenie otrzymuje osobny katalog, a serwer WWW korzysta z dowiązania current. Konfiguracja i trwałe dane mają własne miejsce. Uproszczony, anonimowy układ wygląda tak:
/srv/example-app/
  current -> releases/COMMIT-TIMESTAMP
  previous -> releases/PREVIOUS-RELEASE
  releases/
  shared/
    .env
    storage/
    uploads/
Przygotowanie zależności i zasobów odbywa się przed przełączeniem ruchu. Używamy wersji z plików lock, zamiast aktualizować biblioteki przy okazji publikacji. Skrypt nie generuje nowego klucza aplikacji, nie uruchamia seederów i nie zastępuje produkcyjnego pliku .env zawartością repozytorium.
W tym wdrożeniu procedura buduje zasoby frontendu i publikuje zasoby panelu. Dopiero gotowe wydanie łączy z trwałymi katalogami. Dzięki temu błąd budowania może zatrzymać proces, zanim zmienimy aktywny kod.
Migracje, kolejka i harmonogram wymagają osobnego planu
Po zbudowaniu wydania wykonywana jest kopia bazy przed migracjami. Następnie aplikacja przechodzi w krótki tryb konserwacji, a worker i harmonogram zostają zatrzymane na czas zmiany. Skrypt uruchamia migracje, odświeża cache konfiguracji, tras i widoków, przełącza current, odświeża PHP-FPM i uruchamia procesy.
To wdrożenie z przerwą konserwacyjną, bez deklaracji zerowego przestoju. Sama kopia wykonana przed zatrzymaniem aplikacji nie dowodzi spójnego odtworzenia wszystkich zapisów z okresu przełączenia. Przy odtwarzaniu trzeba uwzględnić nowe dane, sposób wykonania kopii i rzeczywisty test przywracania. Nie utożsamiamy niepustego pliku z potwierdzonym planem disaster recovery.
Procesy działające długo mogą pozostawać przy poprzednim kodzie, nawet gdy strona WWW pokazuje już nową wersję. Dlatego plan obejmuje kolejkę oraz harmonogram. Sposób bezpiecznego zatrzymania pracy i dokończenia zadań zależy od ich długości oraz konfiguracji usług. Ogólne zasady opisują dokumentacja kolejek Laravel i zalecenia wdrożeniowe.
Kiedy można powiedzieć, że wdrożenie się udało?
Wynik polecenia Git nie wystarcza. W naszym skrypcie po przełączeniu sprawdzany jest stan usług, odpowiedzi wybranych stron oraz zasoby CSS i JavaScript potrzebne formularzowi logowania. To konkretny test techniczny, nie pełny test wszystkich procesów biznesowych.
Oddzieliliśmy też aktywację wydania od czyszczenia cache na brzegu sieci. Jeżeli aplikacja działa, ale czyszczenie cache zawiedzie, komunikat wskazuje ten etap. Nie trzeba odruchowo ponawiać migracji i całego wdrożenia. Najpierw ustalamy, co faktycznie się zakończyło, i ponawiamy tylko potrzebną operację.
Rollback kodu nie cofa bazy danych
Ręczne wycofanie korzysta z poprzedniego katalogu wydania. Skrypt ma także ścieżkę odzyskania poprzedniego kodu po błędzie podczas przełączenia. Żaden z tych mechanizmów nie cofa automatycznie migracji bazy.
Usunięta kolumna nie wróci od zmiany dowiązania. Dlatego zmiany schematu warto projektować tak, aby przez okres przejściowy obsługiwały również poprzedni kod. Przy niezgodnej migracji decyzja o odtworzeniu bazy wymaga analizy nowych zapisów i ryzyka utraty danych. Dokumentacja migracji Laravel opisuje ich mechanikę, ale poprawnego planu powrotu dla konkretnej aplikacji nie zastąpi samo polecenie rollback.
Co sprawdzić przed pierwszym automatycznym wdrożeniem?
- Uprawnienia: kto może zmieniać gałąź produkcyjną, uruchamiać pipeline i edytować skrypt na serwerze?
- Powtarzalność: czy z logu wynika aktywny commit i czy drugie wdrożenie nie wejdzie równolegle?
- Dane: czy konfiguracja, sesje i przesłane pliki przetrwają wymianę kodu?
- Błędy: co nastąpi przy nieudanym buildzie, migracji, teście HTTP lub czyszczeniu cache?
- Powrót: czy poprzedni kod współpracuje z nowym schematem i czy istnieje sprawdzona procedura odtworzenia danych?
- Odbiór: kto sprawdzi najważniejszy proces użytkownika po technicznym zakończeniu pipeline’u?
Szerszy kontekst infrastruktury pokazuje realizacja serwera sezonowej aplikacji Laravel. Jeśli chcesz uporządkować publikowanie zmian, sprawdź nasze usługi administracji serwerami Linux oraz rozwój aplikacji i integracji Laravel. Opisz obecny sposób wdrażania i ograniczenia środowiska, a ustalimy proces dopasowany do Twojej aplikacji.